Imagine criar uma tecnologia capaz de transformar a internet, o trabalho, a educação, o marketing, a programação e praticamente todas as áreas do conhecimento.
Agora imagine que, para ensinar essa tecnologia a funcionar, você precisa utilizar uma quantidade gigantesca de informação criada por outras pessoas.
E então surge a pergunta:
Quem é o dono desse conhecimento?
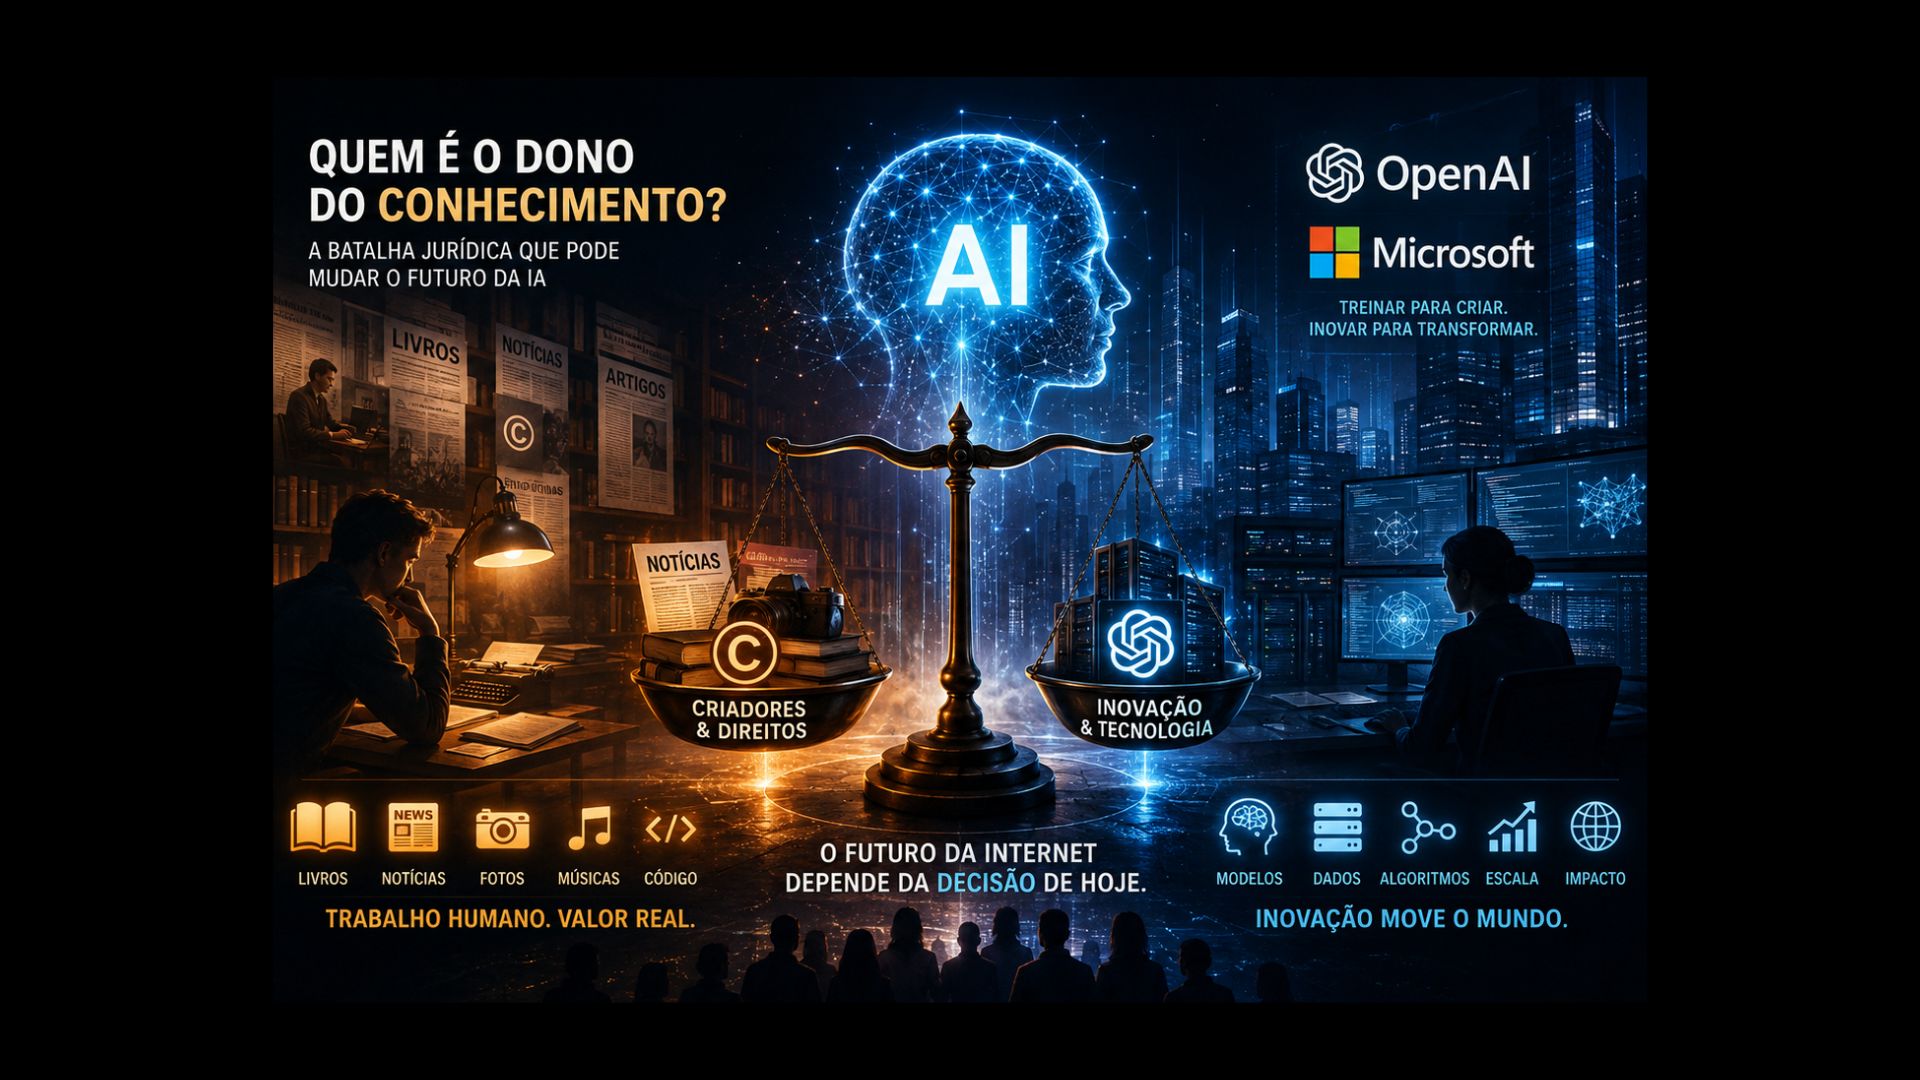
É aqui que começa uma das batalhas jurídicas mais importantes da história da inteligência artificial.
De um lado estão a OpenAI e a Microsoft.
Do outro estão o The New York Times, autores e outros detentores de direitos autorais.
E a questão central parece simples:
Uma empresa de inteligência artificial pode utilizar livros, notícias e outros conteúdos protegidos por direitos autorais para treinar seus modelos sem pedir autorização individual aos seus autores?
A resposta pode parecer apenas uma questão jurídica.
Mas não é.
Dependendo do que os tribunais decidirem, o resultado poderá alterar a forma como modelos de IA são treinados, como criadores são remunerados e até quanto poderá custar desenvolver uma nova inteligência artificial.
🚨 O que está realmente em jogo?
A disputa envolve uma ideia fundamental:
“Fair use” — ou uso justo.
Nos Estados Unidos, a legislação permite determinados usos de obras protegidas por direitos autorais sem autorização do proprietário, dependendo das circunstâncias.
A OpenAI argumenta que o treinamento de modelos de IA é um desses casos.
A empresa afirma que seus modelos não simplesmente armazenam livros ou artigos para reproduzi-los posteriormente.
Em vez disso, durante o treinamento, o sistema analisa enormes quantidades de informação para aprender padrões de linguagem e produzir novos conteúdos.
A OpenAI considera esse processo transformador e, portanto, protegido pelo princípio de fair use.
Mas os autores e empresas de comunicação discordam completamente.
📰 O que o New York Times está dizendo?
O processo do The New York Times acusa a OpenAI e a Microsoft de terem utilizado milhões de artigos do jornal sem autorização para desenvolver e treinar seus sistemas de IA.
Na visão dos autores da ação, não se trata simplesmente de utilizar informação para aprender.
Eles argumentam que as empresas estão utilizando obras protegidas para construir produtos comerciais que podem competir diretamente com os próprios criadores do conteúdo.
E esse argumento muda tudo.
Porque, se um sistema de IA consegue absorver o trabalho de milhares de jornalistas e escritores e depois responder às perguntas dos usuários sem que eles precisem visitar os sites ou comprar os livros originais…
quem fica com o valor económico daquele trabalho?
Essa é uma das perguntas mais importantes desta batalha.
🤯 Agora imagine isso em escala mundial
Pense em todos os conteúdos que existem na internet:
- notícias;
- livros;
- artigos;
- fotografias;
- vídeos;
- músicas;
- pesquisas;
- ilustrações;
- cursos;
- blogs;
- documentos;
- códigos de programação.
Grande parte desse material foi criada por seres humanos.
Agora imagine que uma IA possa utilizar grandes volumes desses dados para aprender.
A pergunta inevitável é:
A IA está aprendendo com a humanidade ou está utilizando o trabalho da humanidade sem pagar por ele?
É justamente essa fronteira que os tribunais estão começando a definir.
⚔️ OpenAI contra autores: duas visões completamente diferentes
A OpenAI defende uma ideia:
Treinar uma IA não é o mesmo que copiar uma obra para vendê-la.
Segundo a empresa, o objetivo do treinamento é extrair padrões estatísticos e linguísticos de grandes conjuntos de dados para permitir que o modelo produza conteúdo novo.
Do outro lado, autores e publishers argumentam que:
Para construir um produto comercial extremamente valioso, a OpenAI utilizou obras que foram criadas por outras pessoas.
E, na visão dos autores, isso deveria exigir autorização e, potencialmente, pagamento.
É uma diferença filosófica enorme.
A IA está aprendendo ou está explorando?
A resposta poderá ser decidida nos tribunais.
💰 E se os tribunais decidirem contra a OpenAI?
Aqui está a parte que pode mudar toda a indústria.
Imagine que o tribunal determine que empresas de IA não podem utilizar grandes volumes de conteúdo protegido sem autorização.
O modelo atual de desenvolvimento poderia sofrer uma transformação profunda.
As empresas poderiam precisar:
💵 Licenciar conteúdos
Pagar aos proprietários dos direitos para utilizar livros, notícias, imagens e outros materiais.
📚 Negociar diretamente com criadores
Autores, jornais, editoras e outros produtores poderiam tornar-se fornecedores de dados para empresas de IA.
🧾 Criar sistemas de remuneração
Poderiam surgir modelos nos quais os criadores recebem de acordo com a utilização das suas obras.
🔐 Restringir os dados utilizados
Os modelos poderiam passar a ser treinados principalmente com conteúdos licenciados ou de domínio público.
E isso poderia aumentar significativamente o custo de desenvolvimento de grandes modelos.
🚀 Mas e se a OpenAI vencer?
O impacto também seria gigantesco.
Uma vitória da OpenAI poderia fortalecer o argumento de que o treinamento de modelos de inteligência artificial constitui uma utilização transformadora das obras protegidas.
Isso poderia dar às empresas de IA maior liberdade para desenvolver novos modelos utilizando grandes volumes de informação.
E poderia acelerar ainda mais a evolução da tecnologia.
Imagine o que isso significaria.
Mais dados.
Modelos maiores.
Mais concorrência.
Mais aplicações.
Mais velocidade de desenvolvimento.
Mas também uma pergunta:
Quem garante que os criadores serão devidamente recompensados?
⚖️ O detalhe que torna este caso ainda mais interessante
A OpenAI não está entrando nessa batalha completamente sem argumentos jurídicos.
Em 2025, decisões de tribunais federais americanos em casos envolvendo Anthropic e Meta consideraram que determinados usos de obras protegidas no treinamento de IA poderiam ser transformativos e enquadrar-se no fair use, embora os casos tenham circunstâncias diferentes.
Isso é importante porque mostra que a questão ainda não possui uma resposta uniforme.
E é exatamente por isso que o caso da OpenAI pode ser tão importante.
🧨 A indústria inteira está observando
Não é apenas a OpenAI que está interessada.
Empresas como:
Google, Meta, Anthropic, Microsoft e muitas outras
também precisam saber quais regras irão prevalecer.
Se o treinamento de IA for considerado legal dentro das atuais regras de fair use, as empresas terão maior liberdade para continuar desenvolvendo seus modelos.
Se os tribunais estabelecerem que determinadas utilizações exigem licenciamento, o cenário muda.
E muda para todos.
📰 O problema também atinge o futuro dos jornais
Existe outro aspecto fascinante.
Durante décadas, os jornais ganharam dinheiro fazendo as pessoas visitarem seus sites para ler notícias.
Agora imagine alguém perguntar ao ChatGPT:
“O que aconteceu hoje no mercado?”
E receber uma resposta completa sem precisar visitar dez sites diferentes.
Para o usuário, isso é fantástico.
Para o jornal, pode ser um problema.
Porque existe uma diferença entre:
“A IA ajudou alguém a encontrar meu conteúdo.”
e
“A IA respondeu ao usuário e eliminou a necessidade de ele visitar meu conteúdo.”
Essa diferença pode representar bilhões de euros e dólares no futuro.
📉 E se a IA começar a substituir a visita aos sites?
Essa talvez seja uma das maiores preocupações dos publishers.
Se as pessoas deixarem de clicar em:
- jornais;
- blogs;
- revistas;
- sites especializados;
- portais de informação;
porque os sistemas de IA já entregam as respostas diretamente…
como esses sites continuarão ganhando dinheiro?
Publicidade?
Assinaturas?
Licenciamento?
Parcerias com empresas de IA?
Talvez surja um novo modelo.
E é justamente por isso que esta batalha jurídica vai muito além de direitos autorais.
Ela também pode redefinir a economia da internet.
💡 O conteúdo pode se tornar uma nova matéria-prima
Existe uma maneira interessante de enxergar essa situação.
Durante a revolução industrial, matérias-primas como petróleo, carvão e metais eram fundamentais para construir produtos.
Na economia da IA, os dados e conteúdos podem ser uma espécie de matéria-prima intelectual.
Livros.
Notícias.
Código.
Imagens.
Vídeos.
Pesquisas.
Documentos.
Tudo isso pode ajudar uma inteligência artificial a aprender.
E se os dados são uma matéria-prima tão valiosa…
quem controla essa matéria-prima?
Essa pode ser uma das grandes questões económicas da próxima década.
🔥 Os criadores podem finalmente ganhar poder?
Existe também um lado positivo para escritores, jornalistas e outros criadores.
Se os tribunais entenderem que as empresas precisam de autorização para utilizar determinados conteúdos, isso poderá criar um enorme mercado de licenciamento.
Imagine:
Um escritor publica um livro.
Uma empresa de IA quer utilizá-lo para treinamento.
O escritor autoriza.
Existe um contrato.
Existe pagamento.
Existe rastreabilidade.
O criador passa a ter uma nova fonte de receita.
Isso poderia criar uma economia completamente nova ao redor do conteúdo digital.
🤖 Mas existe um problema: e se for impossível licenciar tudo?
Agora imagine uma IA tentando aprender com milhões ou bilhões de documentos.
Será que seria possível negociar individualmente com todos os autores?
Provavelmente não.
É por isso que podem surgir novos modelos.
Plataformas de licenciamento coletivo.
Mercados de dados.
Sistemas automáticos de royalties.
Bases de conteúdo certificadas.
Contratos padronizados.
Talvez até uma espécie de “Spotify do conteúdo para IA”, onde empresas pagam para utilizar grandes catálogos de obras.
A tecnologia pode acabar criando uma nova indústria jurídica e comercial.
🚨 A batalha já está entrando em uma fase decisiva
Em 4 de setembro de 2026, OpenAI e Microsoft apresentaram seus pedidos de summary judgment no processo relacionado ao New York Times e aos autores. Os demandantes também apresentaram seus próprios pedidos.
Um summary judgment permite que o tribunal decida determinadas questões jurídicas sem necessariamente levar todo o caso a julgamento, caso entenda que não existem questões materiais de fato que precisem ser decididas por um júri ou por um julgamento completo.
Isso significa que estamos entrando em um momento especialmente importante.
Agora não é apenas uma discussão pública.
As partes estão pedindo ao tribunal que tome decisões concretas sobre os fundamentos da disputa.
🧠 E a OpenAI acredita que o treinamento é transformador
A posição da OpenAI é bastante clara.
A empresa afirma que o treinamento de modelos não tem como objetivo reproduzir as obras originais, mas aprender padrões que permitam gerar novos conteúdos.
A empresa também destaca decisões anteriores que consideraram determinados treinamentos de IA transformativos.
Mas os autores querem que o tribunal considere outra realidade:
sem as obras humanas utilizadas no treinamento, os modelos não teriam a mesma capacidade.
E esse argumento também é difícil de ignorar.
💥 O verdadeiro choque: criatividade humana versus máquinas
Talvez seja essa a razão pela qual essa batalha desperta tanta atenção.
Durante séculos, a criatividade foi essencialmente humana.
Um escritor escrevia.
Um jornalista investigava.
Um fotógrafo fotografava.
Um músico compunha.
Um programador criava.
Agora existe uma máquina capaz de aprender padrões de praticamente tudo isso.
E surge uma pergunta desconfortável:
Se uma máquina aprende com milhões de obras humanas e depois produz algo novo, quanto dessa criação pertence à máquina e quanto pertence à humanidade que a ensinou?
Essa pergunta não possui uma resposta simples.
E talvez os tribunais sejam obrigados a começar a construí-la.
🌎 A decisão americana pode influenciar o resto do mundo
Outro ponto importante:
Mesmo que o processo aconteça nos Estados Unidos, suas consequências podem ultrapassar as fronteiras americanas.
Empresas de IA operam globalmente.
Criadores estão espalhados pelo mundo.
Conteúdos circulam internacionalmente.
E diferentes países estão criando suas próprias regras para inteligência artificial e direitos autorais.
Uma decisão judicial importante poderá influenciar:
- novas legislações;
- contratos de licenciamento;
- acordos entre empresas;
- políticas de dados;
- modelos de negócio;
- investimentos em IA.
Por isso, esta não é apenas uma disputa americana.
É uma disputa sobre as regras da próxima economia digital.
🔮 O que pode acontecer depois?
Existem vários caminhos possíveis.
🟢 Cenário 1 — Vitória da OpenAI
O treinamento de IA recebe uma proteção mais ampla sob fair use.
A indústria ganha mais liberdade.
O desenvolvimento de modelos pode acelerar.
🔵 Cenário 2 — Vitória dos autores e publishers
O treinamento com determinados conteúdos passa a exigir autorização ou licenciamento.
O custo dos modelos pode aumentar.
Criadores ganham mais poder de negociação.
🟡 Cenário 3 — Um meio-termo
Talvez seja o cenário mais interessante.
Os tribunais podem reconhecer que determinados usos são permitidos, mas estabelecer limites para outros.
Isso poderia incentivar um sistema híbrido:
fair use + licenciamento + regras específicas para determinados conteúdos.
E talvez seja exatamente esse tipo de solução que permita que a IA continue avançando sem destruir os incentivos económicos para a criação humana.
💭 Agora pense no que está realmente em jogo
Esta batalha não é apenas:
OpenAI vs. New York Times.
É:
IA vs. modelo tradicional de propriedade intelectual.
É:
dados vs. direitos autorais.
É:
inovação vs. remuneração dos criadores.
E talvez seja também:
o passado da internet vs. o futuro da internet.
🚀 A indústria pode nunca mais ser a mesma
Imagine olhar para trás daqui a dez anos.
Talvez esta disputa seja lembrada como um dos momentos que definiram a relação entre inteligência artificial e propriedade intelectual.
Talvez as empresas de IA tenham de pagar para utilizar determinados conteúdos.
Talvez surjam enormes mercados de licenciamento.
Talvez os criadores passem a receber royalties sempre que suas obras contribuírem para sistemas de IA.
Ou talvez os tribunais concluam que o treinamento é uma utilização transformadora e permitam que a indústria continue funcionando de maneira muito semelhante à atual.
Ainda não sabemos.
Mas uma coisa já está clara:
a resposta será importante demais para ficar apenas dentro de um tribunal.
Ela poderá determinar quem ganha dinheiro com a nova economia da inteligência artificial.
E, principalmente, poderá responder a uma pergunta que ainda estamos aprendendo a fazer:
Quem é o dono do conhecimento quando uma máquina aprende com todos nós?